Domain-Aware RAG:讓 AI 的引用查得到、權限管得住
我的第一篇論文。替傳統金融機構設計一套 RAG 架構,解決「引用來源不可靠」和「權限太粗」兩個問題。
論文RAG資訊檢索
在杭州 ICACTE 2026 講完之後,跟 Session Chair 合照。
A Domain-Aware Retrieval-Augmented Generation Architecture for Traditional Financial Institutions
ICACTE 2026 · 第一作者兼聯絡作者 · 已在杭州完成全英文口頭發表
這篇在解決什麼
傳統金融機構的文件很麻煩:法規、內規、公文、操作手冊、申請表單,每種結構都不一樣,而且一份文件可能同時涉及好幾個業務。
一般的 RAG 放進這種環境會遇到兩個問題:
- 引用不可靠:引用來源通常是 LLM 自己生出來的,有時候對,有時候是它編的。
- 權限太粗:權限只能設在「整份文件」的層級,但實際上同一份文件裡,不同段落該給不同的人看。
三個研究問題
- 文件該怎麼切,才能同時滿足引用和權限的需求?
- 怎麼讓引用來源不靠 LLM 自己生,而是穩定追溯到原始條文?
- 怎麼把權限從整份文件細化到文件裡的子區塊?
我的做法
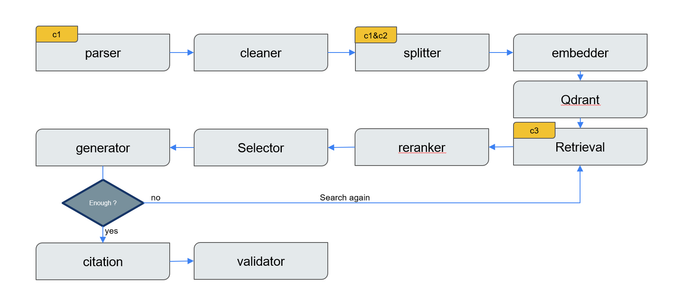
整條 RAG 流程。黃色標籤 c1、c2、c3 是下面三個設計各自作用的位置。
虛擬文件拆分
依照文件類型和業務結構,把一份實體文件拆成多份「虛擬文件」,每一份都有自己的語意和權限。法規照章、節、條、項切;公文、手冊、表單各有各的切法。
階層式麵包屑
在建立索引的時候,就替每個區塊記下它的完整來源路徑(哪份文件、哪一章、哪一條)。引用的出處在 LLM 開口之前就已經確定了,它沒有機會亂編。
子文件層級的權限控制
把存取權限從整份文件下放到虛擬文件。在檢索階段就直接濾掉沒權限的內容,那些區塊根本不會進入候選名單。
結果
| 項目 | 對照組 | 我的方法 |
|---|---|---|
| 檢索到未授權內容 | 35 / 600(文件層級權限) | 0 / 600 |
| 引用正確 | 78%(18/23,LLM 自己產生引用) | 96%(22/23) |
| 引用可以解析到實際來源 | 83%(19/23) | 100%(23/23) |
我做的部分
主導研究問題的定義、系統架構設計、實驗規劃和論文撰寫。
背後的故事
這篇論文的題目不是坐在書桌前想出來的,而是做農會系統的時候被現實逼出來的。當時只是想讓系統好好運作,後來才發現這些工程問題整理一下,其實是可以被研究的問題。